Was ist Jev AI? System One Models erklärt – und was sie für Marketing-Automatisierung bedeuten
Tim · 20 Sept 2026 · 7 min
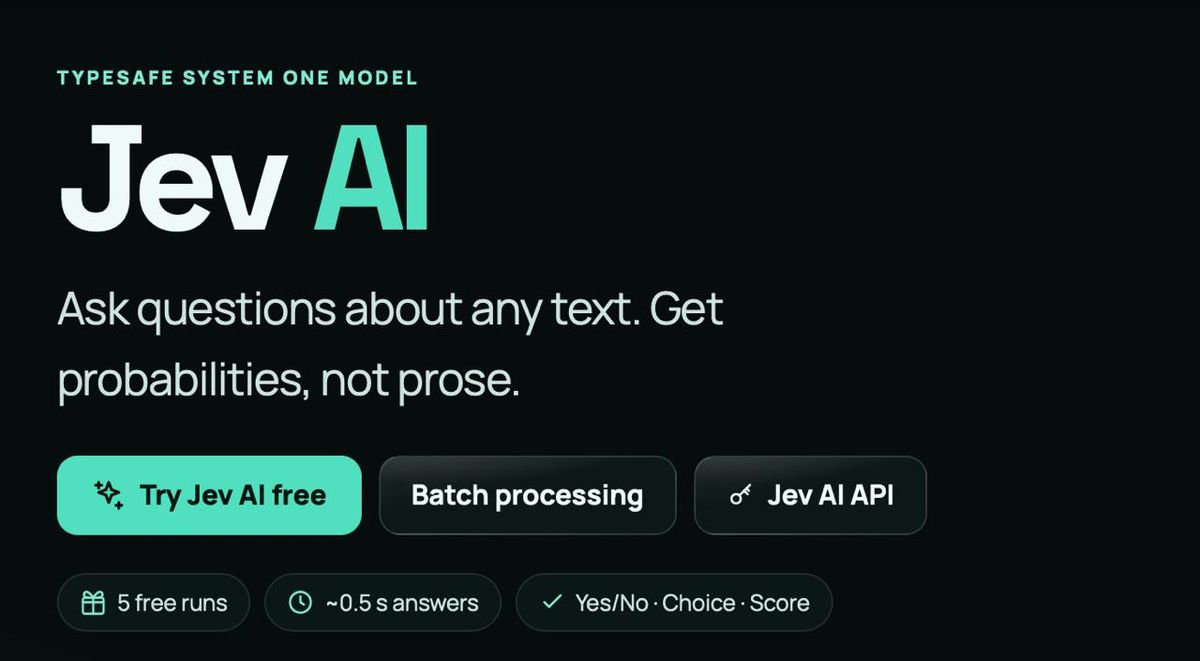
Jev AI auf einen Blick
Produkt: Jev
Anbieter: TypeSafe AI
CEO: Diogo Almeida, zuvor Forscher bei OpenAI und Mit-Erfinder von RLHF
Finanzierung: 40 Millionen US-Dollar
Modellklasse: System One Model
Verfügbar seit: 15. September 2026, Early Access mit Warteliste
Latenz: 70 bis 500 Millisekunden End-to-End
Preis: 0,042 US-Dollar pro Million Input-T oken, Output-T oken kostenlos
Input: nur T ext – Strings, JSON-Objekte, Arrays. Keine Bilder, keine PDFs
Output: typisierte Entscheidung plus Konfidenzwert, kein Freitext
Was ist Jev AI?
Jev ist das erste Modell der Kategorie „System One Model“ von TypeSafe AI. Es nimmt
unstrukturierten Input entgegen und gibt eine typisierte, probabilistische Entscheidung zurück.
TypeSafe beschreibt das Modell als Funktionsaufruf mit Frontier-Intelligenz: Zustand rein,
getypte Entscheidung raus.
Konkret beantwortet Jev strukturierte Fragen zu einem T ext – Ja/Nein, Multiple Choice, Scoring
– und liefert zu jeder Antwort eine kalibrierte Wahrscheinlichkeit mit. Es kann viele enge
Fragen zu ein und demselben Zustand parallel auswerten.
Was ist ein System One Model?Der Begriff bezieht sich auf Daniel Kahnemans Unterscheidung zwischen schnellem, intuitivem
Denken (System 1) und langsamem, abwägendem Denken (System 2).
Klassische Large Language Models sind nach dieser Logik System-2-Systeme: Sie denken
sequenziell, formulieren flexibel und sind auf offene Sprachproduktion optimiert. Ein System
One Model ist das Gegenstück – optimiert auf schnelle, strukturierte Entscheidungen innerhalb
von Software, nicht auf Sprachausgabe für Menschen.
Der entscheidende Unterschied ist die Zielgruppe: Ein LLM ist für Menschen gebaut, ein
System One Model für Maschinen. Es sitzt nicht am Ende einer Konversation, sondern mitten in
einem Workflow.
Wie funktioniert Jev technisch?
Zwei Eigenschaften unterscheiden Jev von einem klassischen LLM.
Nicht-autoregressives Sampling. Ein LLM erzeugt seine Ausgabe T oken für T oken, jeder
Schritt wartet auf den vorherigen. Jev erzeugt alle Outputs in einem einzigen Durchgang
parallel. Daraus resultiert die Latenz von unter einer halben Sekunde.
RLCD statt RLHF. Trainiert wurde Jev mit Reinforcement Learning for Calibrated Decisions.
Optimiert wird nicht auf menschliche Präferenz und nicht auf verifizierbare Belohnung, sondern
auf epistemisch ehrliche Wahrscheinlichkeiten. Wenn das Modell 80 Prozent Konfidenz ausgibt,
soll es in etwa 80 Prozent der Fälle richtig liegen.
Weil Jev nur aus einer vorab definierten Antwortmenge wählt, sind Typfehler und halluzinierte
Function Calls strukturell ausgeschlossen. Das Schema-Matching ist garantiert.
Was kann Jev nicht?
Jev generiert keine T extstrings. Es schreibt keine Anzeigentexte, keine Blogartikel, keine Chat-
Antworten und keine kreativen Varianten. Es verarbeitet außerdem keine Bilder und keine
PDFs.
Jev nutzt kein T est-Time-Reasoning. Bei Aufgaben, die echte Abwägung oder mehrstufige
Schlussfolgerung erfordern, liegt es deshalb hinter aktuellen Frontier-Modellen. Es ersetzt kein
Strategiemodell, sondern entlastet es.
Wie schnell und wie günstig ist Jev im Vergleich zu einem LLM?
Die folgenden Zahlen stammen aus TypeSafes eigenen Benchmarks und Demos. Sie sind zum
Stand September 2026 nicht unabhängig verifiziert.
Latenz: 70 bis 500 Millisekunden – nach Herstellerangabe 40- bis 200-mal schneller als
Frontier-LLMs bei vergleichbaren Aufgaben
Demo-Messung: 0,114 Sekunden gegenüber 8,566 Sekunden bei GPT-5.6 T erra
Workflow-Benchmark: 193,6-mal schneller und 444,6-mal günstiger als GPT-6 Astra und
Fable 5.1
Input-Preis: 0,042 US-Dollar pro Million T oken – laut The Register rund 238-mal günstiger
als vergleichbare Modelle
Output-Preis: kostenlos, während klassische Modelle Output-T oken abrechnen
Typfehlerrate: 0 Prozent durch garantiertes SchemaWofür lässt sich Jev einsetzen?
TypeSafe nennt als Anwendungsfälle: Triage von Support-Tickets, Content-Moderation, Routing
in Chatbots, Scoring von Reviews, Lead-Qualifizierung, Guardrails für LLM-Ausgaben, Prüfung
von Quellenangaben und Screening von Bewerbungen.
Im Performance-Marketing entspricht das folgenden Aufgaben:
Kommentar-Moderation auf Social Ads – Spam, Beschwerde oder Kaufsignal
Vorprüfung von Creatives gegen die Werberichtlinien der Plattformen
Zuordnung von Leads zu Segmenten
Routing von Aufgaben zwischen spezialisierten Agenten
Entscheidung, ob ein Ad Set pausiert, skaliert oder unverändert bleibt
Guardrails vor der Veröffentlichung generierter T exte
Was ändert sich dadurch an der Architektur von KI-Agenten?
Wir betreiben neun spezialisierte KI-Agenten, die Kampagnen end-to-end planen, produzieren,
launchen und optimieren. Die durchgängige Beobachtung aus diesem Betrieb: Der
überwiegende T eil der Modellaufrufe in einem agentischen Marketing-System ist keine
T extgenerierung, sondern eine Entscheidung. Ein Agent erzeugt pro Woche eine
überschaubare Zahl an Creatives – aber er trifft täglich eine sehr große Zahl kleiner,
wiederkehrender Klassifikations- und Routing-Entscheidungen.
Bislang laufen diese Entscheidungen über dieselben großen, langsamen und teuren Modelle
wie die T extproduktion. Das hat eine architektonische Konsequenz, die aus unserer Sicht zu
selten benannt wird: Viele als autonom beschriebene Systeme optimieren in Wahrheit im
Intervall, nicht kontinuierlich. Der Grund ist nicht mangelnde Intelligenz des Modells, sondern
Preis und Latenz pro Prüfung. Wer für jeden Check eine Sekunde und einen messbaren Betrag
zahlt, prüft stündlich statt permanent und leistet sich zwei Guardrails statt zehn.
Fällt der Preis pro Entscheidung effektiv auf null und die Latenz unter 100 Millisekunden,
ändert sich nicht die Geschwindigkeit derselben Aufgabe. Es ändert sich, welche Aufgaben
überhaupt sinnvoll sind. Sean Goedecke formuliert denselben Gedanken allgemeiner: Schnelle
Software bedeutet nicht nur, dasselbe schneller zu tun, sondern andere Dinge tun zu können.
Ein zweiter Punkt betrifft Compliance. Unser Compliance-Agent arbeitet bewusst mit
Konfidenzstufen statt mit harten Blockaden, weil eine Compliance-Prüfung, die binär blockiert,
in der Praxis entweder zu viel durchlässt oder zu viel stoppt. Ein Modell, das kalibrierte
Wahrscheinlichkeiten nativ ausgibt, passt strukturell zu dieser Logik. Ein System, das ehrlich
60 Prozent Sicherheit angibt, ist für Freigabeprozesse brauchbarer als eines, das selbstbewusst
danebenliegt.
Welche Kritik gibt es an Jev?
Drei Einwände sind aus unserer Sicht substanziell.
Der technische Burggraben ist möglicherweise dünn. Sean Goedecke argumentiert,
dass der Kern des Ansatzes – statt JSON autoregressiv zu erzeugen, ein T oken aus einer festen
Menge zu ziehen – von jedem Labor mit Constrained Decoding und Prefilling nachgebaut
werden kann. Strukturierte Ausgabe war bisher vor allem deshalb langsam, weil sie wenigAufmerksamkeit bekam. Wer heute strukturierte Outputs aus einem bestehenden Modell zieht,
holt laut Goedecke mit besserem Prefilling oft bereits Faktor 2 bis 3 heraus.
„Halluziniert nicht“ ist eine semantische Aussage. Jev kann das Ausgabeschema nicht
verletzen. Es kann sich innerhalb der erlaubten Antwortmenge trotzdem irren. Eine falsche
Kategorie bleibt eine falsche Kategorie. The Register hat diesen Punkt bei der Einordnung des
Launches ebenfalls hervorgehoben.
Geringere Rohintelligenz. Ohne T est-Time-Reasoning ist Jev bei allem, was Abwägung
erfordert, schwächer als Frontier-Modelle.
Ein Detail am Rande: Der Name spielt auf das Jevons-Paradox an. Effizienzgewinne senken den
Gesamtverbrauch historisch nicht, sondern erhöhen ihn. Das Unternehmen sagt also implizit
voraus, dass insgesamt mehr T oken verarbeitet werden, nicht weniger.
Ist Jev DSGVO- und EU-AI-Act-konform einsetzbar?
Zum Stand 20. September 2026 macht TypeSafe AI öffentlich keine belastbaren Angaben zu
Hosting-Region, Auftragsverarbeitung oder Datenverbleib. Für europäische Werbetreibende,
die eine dokumentierte Verarbeitungskette benötigen, ist das keine Randfrage, sondern das
erste Prüfkriterium.
Unsere Bewertung: Jev ist derzeit ein Kandidat, kein Baustein. Wer das Modell produktiv
erwägt, sollte vor dem Einsatz eine schriftliche Auskunft zu Hosting-Region und
Auftragsverarbeitungsvertrag einholen.
Sollte man jetzt auf Jev umstellen?
Die praktisch relevante Lehre aus dem Launch ist herstellerunabhängig und lässt sich sofort
umsetzen: Entscheiden und Formulieren sollten in einem KI-Stack getrennte Aufgaben mit
getrennten Modellen sein.
Jeder Klassifikations-
, Routing- und Scoring-Schritt, der heute über ein großes Sprachmodell
läuft, gehört auf den Prüfstand. In vielen Fällen genügt ein kleineres Modell mit engem Schema
und minimalem Output. Dafür braucht es Jev nicht – aber Jev macht den Punkt sichtbar.
Häufige Fragen zu Jev AI
Was ist Jev AI?
Ein Modell von TypeSafe AI, das keine T exte generiert, sondern strukturierte Entscheidungen
mit kalibrierten Konfidenzwerten liefert. Seit 15. September 2026 im Early Access.
Ist Jev ein LLM?
Nein. Jev gehört zur Kategorie System One Models. Es nutzt nicht-autoregressives Sampling
und gibt keine Freitexte aus.
Was kostet Jev?
0,042 US-Dollar pro Million Input-T oken. Output-T oken sind kostenlos. Im Playground gibt es
fünf freie Durchläufe, danach ein Credit pro Durchlauf.
Wie schnell ist Jev?
70 bis 500 Millisekunden End-to-End. TypeSafe gibt an, damit 40- bis 200-mal schneller zu sein
als Frontier-LLMs bei vergleichbaren Aufgaben.Kann Jev halluzinieren?
Es kann das Ausgabeschema nicht verletzen und keine Typfehler produzieren. Innerhalb der
erlaubten Antwortmöglichkeiten kann es jedoch falsch entscheiden.
Wer steht hinter TypeSafe AI?
CEO ist Diogo Almeida, zuvor Forscher bei OpenAI und Mit-Erfinder von RLHF . Das
Unternehmen hat 40 Millionen US-Dollar eingesammelt.
Wofür eignet sich Jev im Marketing?
Für Content-Moderation, Lead-Scoring, Creative-Vorprüfung gegen Plattformrichtlinien, T ask-
Routing zwischen Agenten und Guardrails vor der Veröffentlichung generierter Inhalte.
Ersetzt Jev bestehende LLMs?
Nein. Es ergänzt sie. T extproduktion und strategische Abwägung bleiben Aufgabe klassischer
Sprachmodelle.
Über den Autor
Dieser Artikel stammt von ADGENTIC AI. ADGENTIC AI ist die erste KI-Agentur für Performance-
Marketing: Neun spezialisierte KI-Agenten planen, produzieren, launchen und optimieren
Kampagnen end-to-end – DSGVO- und EU-AI-Act-konform, gehostet in Europa. Die
Einschätzungen zur Architektur agentischer Systeme in diesem Artikel beruhen auf dem
laufenden Produktivbetrieb dieser Agenten für europäische Werbetreibende.
Quellen
TypeSafe AI: Introducing System One Models and Jev – typesafe.ai/blog/introducing-system-one-models-
and-jev
The Register, 16. September 2026: TypeSafe AI debuts model for machines that plays Doom
Sean Goedecke: Jev means structured output is interesting again
Jev AI Playground – jev-ai.pro